日曜日, 12月 23, 2012

【BPStudy#64】RDBじゃだめな理由を2つほど このエントリーを含むはてなブックマーク

皆さん、昨日はお疲れ様でした。 また、運営していただいたBeProudの皆さん、ありがとうございました。

10人くらいだったら完全非公開にしようと思ったんだけど、30人くらい来てくれたので公開することにしました。 UST録画はこちら


BDBの代わりにRDBのインスタンスを複数配置するんじゃだめなの?というのはよく聞かれる質問だけど、昨日も当然のように質問された。

いつもうまく答えられなくて歯がゆいけど、それは、O/Rマッパーも必要なくなって、RDBを導入管理する必要がないから。だけど、そこはやっぱり伝わんなかったかな~。

O/Rマッパー無くしてソフトスキーマで


開発の4割がマッピングといわれ、 それに、テーブル設計、正規化、SQL、チューニングなど、 ほとんどがデータベースまわり。要は、これを全否定したいわけ。 直接オブジェクトを格納するわけだからO/Rマッパは不要になる。

 昔、EUC(Enduser computing)とか言ってたっけ。 
Lotus Notesでアプリ開発したことある人ならわかると思うけど、 RDB不要な感じでスキーマを自由に作れる開発環境は、(流行ってるかどうかは別として)、珍しいものでも何でもなく、一度経験するとその高い生産性に慣れてしまって、もう元には戻れなくなる。RDBは大変な負荷だったんだと気づく。

最近では Google App Engineや最近ではBaaSといったWebサービスもソフトスキーマで、アプリケーション内で自由に項目を設定できる。

ACIDのDどうすんの?

   だって、APサーバごとにRDB導入するわけにはいかないでしょう? だから普通はDBサーバのインスタンスを分けようという話になる。でもそれだけでスケールするんだったら苦労なんてしないわけ。 
 結局、AP側にキャッシュを入れようという話になって、今だとRedisが使われるじゃないですか。で、永続化すればI/Oが詰まるので、どう溜めるかをよく考えないといけなくなる。つまり、ACIDのDをどうするか。トランザクションリカバリーとか、むしろ障害対策を頑張って作る必要があるんだけど、皆さんどんなふうに解決しているんだろうね。Append only fileで頑張ってる? まあ、2.4で非推奨になったVirtual Memoryを自力で作るぐらいの覚悟があれば大丈夫なんだろうけど。
 一方のBDBは、DBMSと同等のACIDがあるので、トランザクションログからのリカバリもDBMSと同じようにできる。単純なログファイルに書かれるだけだから、スケールアウトして複数ノードになったとしても運用はチョー楽チンだ。

BDBは、他のKVSと比較して特別に速いもんじゃないし、高機能というわけじゃない。
でも、APのプロセスで動作する一つのjarがあって、処理自体は当然メモリー内で実行されるからキャッシュ技術と同等のパフォーマンスぐらいは出せる。また、APサーバ内だけで完結するからDBサーバは実質的になくても動作する。この辺りが魅力かな。

ついでにスクリプト言語も(ry


もうそろそろ、サーバはデータを返すだけでよくないか? 

Javaなんかダセーって、一方で、HTMLタグが混在したスクリプト言語のソースを堂々とgithubで晒している。そして、パフォーマンスを競って、サーバのレンダリングを一所懸命チューニングしている。 どうかと思うよ。

twitterの例はあるとは思うけど、レンダリングはクライアントでもう十分だろ?

こんな感じで、乱筆すみませんでした。

みなさん、よいお年を。

火曜日, 12月 11, 2012

ReflexWorks開発における選択と集中の話 このエントリーを含むはてなブックマーク


何事も選択と集中が大事です。時間もお金も人も無限にあるんだったら何も苦労しません。私たちは、ReflexWorksを作るにあたって何を自作すべきか、あるいは他を利用する方がいいのか、色々悩みながら開発してきました。

標準化技術は採用すべきでしょうし、車輪の再発明は避けるべきでしょう。それは当然です。私たちも無い機能は作るし既にあれば利用させていただくという方針で基本的にはやっています。

かつてJava全盛の時代は楽でした。単にJavaの標準化技術を後追いすればよかったからです。でも、今はなかなか思うようにいきません。

10年ぐらい前からJavaの動きに鈍くなり、後追いだけでは対応できなくなってきました。
今盛んに訴えられている、JavaScriptやThin Server Architectureの重要性の話なんて(私には)4年ぐらい前のメッセージに聞こえます。

ReflexWorksもThin Server Architectureが基本ですが、既に大規模事例があり1年以上前から運用されています。
ということはどういうことか。システム構築開始は2年前で、ReflexWorksの開発はもっと前ということです。

今、JavaのThin Server Architectureに影響を受けた人が、これからフレームワーク作ってシステム構築して運用したとして、評価されるまであと何年かかるのでしょう?そのときデビューして果たして競争力はあるのでしょうか。(ReflexWorksに競争力があるとは到底思ってませんが・・)

JSONにしても2006年時点では自作するしかありませんでした。シリアライザもXML pull parserもXStreamを改造して使っています。
でも、これは当時の事情でしかたなくです。今ではご存知のようにJAX-RSなどのJavaの標準APIがあります。でも遅いんです。

今更、それに準拠するためだけにフレームワークを修正することは、少なくとも私たちにとっては無意味です。
それは、ReflexWorksフレームワークのテストには数年、数百人月という膨大な工数が費やされており、高い品質を維持しているからです。
品質は不具合の数だけでなくパフォーマンスやセキュリティなど総合的な評価が大事です。いくらJava標準といっても品質が高いとは限りません。

テストがきちんと実施され本番でも期待通りに動作している。これが最も価値ある状態であり、これでやっと他のお客様にも自信をもって最高のパフォーマンスを提供できるのです。

一方で、そのクオリティをさらに高める努力をしていくつもりです。継続的に投資していきます。

例えば、MessagePack対応。

ReflexWorksのボトルネックである、通信とシリアライザと永続化の3つの大きな要素のうち、通信とシリアライザについてMessagePackを採用することで大きな改善を見込めます。

残る永続化の部分ですが、私たちはKVSをゼロから作るなんて無謀なことはいたしません。世の中にある優れたKVSを利用しようというスタンスです。
現在はOracle BDB JEと、Google App EngineのDatastoreの2つを採用しています。(選択できます)

Oracle BDB JEを採用している理由は信頼性です。いい意味で枯れており、情報が豊富で、何よりOracleの技術サポートを受けられます。(保守契約が必要)
FAQを見ていただけるとわかりますが、トランザクションログのリカバリやトラブルシューティングも大変わかりやすく運用も楽です。

BerkeleyDB JE FAQ

トランザクションはロック方式ですが、現在はそれほど大きなボトルネックになってはいません。(他の改善効果に比べて低い)

パフォーマンスに優れたKVSは他にもいろいろありますが、トランザクションをサポートしており、かつ安心して利用できるという点で、BDB JEには一日の長があると考えています。

とはいえ、私が知らないだけかもしれません。他に信頼性に絶対的自信のあるKVSがあればぜひご紹介ください。
ちなみに、次の候補としては、Amazon DynamoDBを検討しております。


月曜日, 12月 10, 2012

バーチャルがリアルに語ります。本物のクラウドを。 このエントリーを含むはてなブックマーク


BPStudy#64の集まりが悪いので決めました。 少人数だからできる本音トーク。資料も上げたりしません。tweetもやりません。ふっふっふ。 プライベート・クラウドは良くないアイデアっていうけれど本当は凄いこと。規模の経済性だけでは語れない、本当のプライベートクラウドのメリットは確かにある。それを僕は今回のプロジェクトで体験した。 この感動を来てくれた皆に伝えたい。

300万トランザクション/日を処理するスケールアウト型オンライン帳票システムの仕組み


Agenda(案) ※内容が変わる可能性があります
  • 分散KVSについて
    • なぜ分散KVSを採用したか
      • RDBのインスタンスを複数持つんじゃだめなの?
      • RedisやMongoDB、Cassandra、HBaseじゃだめなの?
    • 分散KVSを業務アプリで使うには
  • トランザクション処理
  • スケーラビリティ
    • シャーディングのPros/Cons
  • パフォーマンス
    • 本当のボトルネックはどこか
    • Thin Server Architecture
      • 動的コンテンツをサーバで作成しない
      • 帳票作成においてサーバに負荷をかけない
  • 可用性
    • ミッションクリティカル。でも実際は・・。
    • 実際に障害に遭遇した話
  • まとめ
    • 全体最適解としてのプライベートクラウド

土曜日, 12月 01, 2012

ajn22のBTで発表してきました このエントリーを含むはてなブックマーク


ajn22、皆さんお疲れさまでした! 

また大変盛り上がって楽しかったですね〜。ajnのこの独特の楽しい雰囲気の源は一体なんだろうといつも思います。単なる事例紹介とは違って、秒間最大2000reqを処理する大規模なサービスだったり、SharededCounterの議論だったり、機械学習だったり、あるいは、クライアントMVCやリアクティブプログラミングといったことを、皆さん独自の視点や発想で研究実践され、そしてそれが惜しげもなく披露される。それは刺激的です。 

そりゃ、勉強も大事ですよ。並列分散トランザクション技術やリアルタイム処理、関数型言語・・・、いろいろ勉強しないといけない。でも、それらは実際に使われてナンボなわけで、そこからは実践的なプラクティスはなかなか生まれてこない。

ところがajnでは実際に数億のトランザクションを運用していてCounterがボトルネックなんですよ〜という話が出てきて議論が始まり、そこで、実はShardedCounter がいまだにベストプラクティスということを知るわけ。過去議論したSkiplistとか、Memcacheの利用、あるいはロックフリー技術とか駆使して何とか解決できればいいのだけれど現状はまだまだという感じ。これは大きなテーマだから今後もぜひ研究していきたいところですね。私自身、モチベーションの原点を再発見した感じです。 

あと、DEMOを見ていただいた方にお願いです。

以下のFacebookページにもいいねしてあげてください。(昨日言い忘れてました)


公報一括ダウンロードサービス

以下にTwitterのまとめと僕の資料を置いておきます。
それでは。


金曜日, 8月 17, 2012

ぶいてく流 スケーラブルアプリの作り方 2012 (前編) このエントリーを含むはてなブックマーク

明日のクラウド温泉3.0@小樽の発表資料の前編(導入部分のみ)を公開しておきます。ちょっと詰め込みすぎて1時間以内に終わらないこと確実なので・・・。あらかじめ読んでおいていただけると嬉しいです。

日曜日, 7月 08, 2012

RESTに関する3つの間違い このエントリーを含むはてなブックマーク

楽観的排他制御を利用する非同期的なトランザクション実行であればスケーラビリティを損ねることなく2phase commitが可能である。これは、分散KVSにおけるスケーラビリティと一貫性の両立について で主張したように、同期的な2phase commitは密結合に誘導することになるため、矛盾するように思えるかもしれない。だがそんなことはない。
前半はまずこの話から入るが、後半ではRESTに関する間違いについて、3つほど思うところを述べたい。

楽観的排他制御と2phase commit

 reflexworksではFeedやEntry単位でatomicなトランザクション処理を行えるが2phase commitはサポートしていない。これを許すと密結合になってスケールしないからである。だが、これはあくまで同期的な処理の話であって、ネットワーク障害への耐性を考慮され、非同期処理やオフラインで使えるのであれば2phase commitでもスケールすると考えている。
 RESTにおける2phase commitについては、REST におけるトランザクションについて (Re: Web を支える技術) が詳しい。
トランザクションレイヤを RESTful に表現する手法は理解しておいて損がないものだと思います。具体的には、
  • トランザクションの開始は POST を使ったトランザクションリソースの生成
  • トランザクション開始後は POST ではなく PUT を使い、クライアントがリクエスト ID を指定することで、ネットワーク障害への耐性を確保
  • トランザクションのコミットも再送可能じゃないと困るので PUT
  • コミットの返り値を確認してからトランザクションリソースを DELETE
といったあたりが基本になると思います。
ポイントは、クライアントがリクエスト ID を指定する点。IDはPOSTで返却されたリソースIDになるが、楽観的排他制御のためには、論理シーケンス番号 (LSN)も同時に必要になるはずだ。
もう少し具体的に説明しよう。

reflexworksでは、LSNに該当するものはリビジョン番号であり、POST /buy でリソースURL(/buy/934085,1)が返却される。(この,1がリビジョン番号で更新の都度+1される)次に、 PUT /buy/934085,1 を実行。もし既に更新されていたらリビジョン番号不一致となるため、409 conflict(optimistic locking failed)が返る。DELETEも同じくリビジョン番号を指定して実行する。
前述の例では自分しか更新しない前提ではあるが複数回実行される可能性は考慮すべきところで、べき等性の保証が必要なのだが、この場合は楽観的排他エラーで「既に更新されています」というメッセージを出してあげる方が親切だと思われる。
ちなみに、同一リソースURLでリビジョン番号も同じであれば、システム全体で同じものであることが保証されている。これは、複数のノードに散在するデータの整合性を保証するためのreflexworksの基本的な考えにもなっている。(エンタープライズクラウドにおけるスケールアウトの現実解)

また、POSTはリソース作成時にのみ使い、PUTは既存のリソース更新に使うのはrelfexworksも同様である。「 一般に、リソース作成時に PUT を使うべきでないとされる理由は、クライアント間で名前の競合が発生する可能性があるから」という理由はもちろんだが、CRUDの4つは明確に区別したいという理由もある。SQLにおいても、INSERTとUPDATEは区別されている。

RESTはステートレスでなければならないか

さて、ここからRESTの3つの間違いの話に入る。
ステートレスはRESTの原理原則であり、実際に疎結合にすることでシステムはスケールラブルになる。私は、ステートレスをスケーラビリティ確保の絶対条件と考え、reflexworksではセッションは使わない方針を貫いてはいた。そして、ログイン処理においてさえセッションIDは使わずに都度認証することを徹底していた。たしかにステートレスにするとスケールはする。だが、最近は度が過ぎるとかえって不自由な設計を招いてしまうことになることがわかってきて、逆にセッションはアリなんじゃないかと思うようになってきた。

はっきりいおう。私は間違っていた。


一つは、ユーザログイン管理において毎回認証を実行させる必要があり、擬似的なセッションIDを発行する必要があったこと。具体的には、認証に成功したら新たに時間制限をつけたcookieチケット(ワンタイムパスワード)を発行し擬似的なセッションIDで対応していた。また、そのチケットはあくまでログイン認証用であり、セッションオブジェクトは管理しないようにしていた。ユーザにログイン入力を強要させるわけでもなく、名前もStateless Session ID(SSID)にしていた。
 しかし、ユーザIDとワンタイムパスワードを含むトークンを毎回クライアントと通信してやりとりするのはセキィリティ上よろしくない。私は頑にステートレスを守る一方でセキュリティをないがしろにしていたわけだ。
 また、パフォーマンスも悪くなる。
前述した2phase commitでは、払い出したチケット(/buy/934085,1)は一時的な揮発性の情報であり、これらはむしろセッションオブジェクトかキャッシュメモリに置くべきである。こうすることで、パフォーマンスも格段によくなり、KVSとの間にメモリという緩衝材が入ることでI/O負荷も軽減できる。
というわけで、最近はRESTであっても必要最低限のセッションオブジェクトだけは認めてもいいと考えるになった次第である。実際に最新版のreflexworksでは標準のセッションオブジェクトが使えるようになっている。また、一時的なオブジェクトはなるべくキャッシュさせるような設計を推奨している。

リソースは本当にドメインロジックを必要としないか

2つ目の間違いはリソースとドメインロジックの置く場所についてである。
MVCの話のなかでも触れてはいるが、ドメインロジックはバウンダリだけでなくコントロールやエンティティの層においても構わない。


にもかかわらず、当初のreflexworksでは、リソースを特定するURLに対して単純なHTTPリクエストのCRUD操作(GET,PUT,POST,DELETE)しか用意していなかった。
これだと、例えばECサイトの金額チェックなどをサーバ側で行うことができない。金額を正確にチェックするにはサーバ側でマスター参照する必要があるはずである。たとえ認証を付けたところで、リクエストデータが正しいかどうかという話は別である。どんなに頑張ってクライアントでチェックしてもサーバ側では無条件では受付けられない。
だからといって、自由にサーバ側のインターフェースを作らせたくはない。
サービスを自由に作らせると、きっとこんな感じのインターフェースになってしまうだろう。

entry = getFoo(entry)
entry = updateFooByBar(entry)
・・・

これでは、サービス志向の二の舞になってしまう。せっかく、RESTでリソースを一意に定義できているのだから、こういう感じにしたい。

entry = Foo.service(entry)

 例えば、GET  /p/Foo?item=abc などと実行すると、/p servletが呼び出され、URLパラメータとentityにもとづいて処理されるといった感じになる。/p servletの中では、reflexContext.get("Foo");とすることで実際のリソースにアクセスできる。(もちろん、POST,PUT,DELETEメソッドもある)

ちなみに、/d/Fooに対して実行すると、/d servletが呼び出され、以前のバージョンと同様に、サービスは実行されずにリソースの内容がそのまま返される仕組みとなっている。(/dはdata、/pはproviderの頭文字)

最近では、単純にデータだけが提供される、BaaS(Backends as a Service)やDBaaS(Database as a Service)が流行っているが、本当にサービスのドメインロジックが必要ないか、よく検討して使うべきだろう。

イベントドリブンなアーキテクチャーは受け入れられるか

先日、MOVEが話題になった。
コントローラをOperationsとEventsに分けた方がいいという案だが、望まれなかった子にあるように、MVCの一つの解釈(あるいは間違えているの)であり、MVCを否定するものではない。
ただ、closureや、あるいは、Deferredのような非同期処理をなんとか中心に考えたいという気持ちもわからないでもない。

実は、reflexworksでもイベントドリブンな設計はいけると思った時期があった。実際にイベントをトリガーにサーバサイドJSを実行できる。でも開発者の多くが難しいと感じ、オーソドックスな方を好んだので、今は廃止しようと考えている。オーソドックスな方とは、前述したような単純な/p servletによるフィルターのような処理のことである。

単にユニークであることが使いやすいとは限らない。


また、コントローラをOperationsとEventsに分けるより大事だと思うのは、Modelをデータ(スキーマ)とドメインロジックに分けることである。スキーマは一貫させる一方でドメインロジックは各レイヤの最適な場所に配置させる。貧血症みたいなオブジェクトにはなってしまうが、それを恐れてはいけない。

以上が、RESTに関して私が犯した間違いの3点である。
だが、もしかしたら、こうやって原理原則を修正した結果、RESTのアーキテクチャーとは到底呼べないものになってしまっているかもしれない。だがそれでも構わない。なぜなら、これらは実務に落としたときに実際に問題となって一つ一つ解決してきたものだからである。

今流行のリーンスタートアップ流にいうなら、クールなアーキテクチャだと思って採用(Build)するのは結構なことだが、測定(Measure)して、学習(Learn)してから最終的に判断しないとだめである。それが本当に素晴らしいかどうかは、実務に落としたとき初めてわかるものだから。

<ご紹介>
reflexworks           <= 製品についてはこちら
reflexworksで分業開発しよう!  <= 開発案件募集中です


月曜日, 7月 02, 2012

KVS上でアプリを動作させるために必要なたった2つのこと このエントリーを含むはてなブックマーク

先の記事で、ReflexWorksにおけるデータ操作の方法について触れ、ツリー構造の仮想フォルダ管理とREST APIによるデータアクセスについて説明した。ここでは、もう少し掘り下げて、KVS上でアプリを動かすための条件とは何なのかについて考えてみたい。(たった2つのことといいながら長文失礼します)

SQL vs NoSQL: Battle of the Backends

タイムリーにも、Google IO でSQL vs NoSQL: Battle of the Backendsというセッションがあったようだ。ここでは、SQL(MySQL)とNoSQK(Datastore)を、Queries、Transactions、Consistency、Scalability、Management、Schemaの6つの項目について比較していて、前半の3つについてはSQLが、後半の3つについてはNoSQLが優れているという結果になっている。最後は両者同数でどっちもどっちだね、みたいな話になっているが、セリングトークも含まれるのでこれは真に受けて欲しくない。とにかく、これまで主張してきた通り、トランザクションが増えるとRDBがボトルネックになり、オンライン処理ではそのうち限界になってくるはずだ。
 また肝心のパフォーマンスについては、「基幹系システムでCloud SQLは使えるか試してみた」を見てもわかるように、Datastoreとはまだ相当の差があるようだ。

とはいえ、丸山先生もおっしゃっているように、GAEでもMySQLが使えるようになったことは、まあ、それはそれで結構なことだとは思う。(ということでお茶を濁す)

アプリにKVSを意識させないことが大事

さて、今WebアプリといえばHTML5などのリッチコンテンツが主流である。クライアント上のネイティブアプリのように小気味好く動作することが求められている。またスマートデバイスではオフラインや非同期更新などもある。もはや、JSPやJSF、あるいはPHPでHTMLを動的に作るといった古いアーキテクチャーは通用しない。エンジニアは利用者に最大限のエクスペリエンスを与えようと頑張っており、UI/UXに多くの時間と労力をかけている。可能なかぎり画面だけに集中したいと思っているはずだ。なので、JavaScriptを中心としたフレームワークのムーブメントが今起きていると思う。

このような要求にもReflexWorksであれば対応できる。ReflexWorksは、疎結合を基本としているためクライアント開発者がUI/UXに専念できるように、なるべくサーバ開発を意識させないようにしている。クライアントはシンプルなREST APIでサービスを呼び出すことだけ考えればよく、結果もJSON/XMLで取得できる。

KVSで業務アプリを動かす条件とは

冒頭で、GAEではDatastoreはよいがCloudSQLはビミョーであるといった。
一方、AWSのRDSやSQL Azureはまずまずのようだが、実は、Amazon DynamoDBや、Azure Storage Service(KVSの方)にもビミョーなところがある。

一つ目はトランザクション。
GAEではEG(エンティティグループ)のトランザクションが扱える。Azure Storage Serviceでも、同一テーブル、Partitionkeyのデータはトランザクション処理可能である。しかし、DynamoDBではトランザクションを扱えない。(ドキュメントによるとatomic counter程度はできそうだが・・)


http://www.slideshare.net/kentamagawa/amazon-dynamodb-11808513
クラウドのエンタープライズ利用を考えた場合、数msで返せるとか、数万qpsとかいっても単体のスループットであれば実はそれほど重要ではない。ブラウザ表示で数msと数百msの違いは感じられないので、単純にKVSパフォーマンス比較してもあまり意味はない。逆にどんなに高速でもトランザクション非サポートは痛い。トランザクション機能がないと結局は参照系など用途は限定されることになるため、単体性能は悪くてもノードを増やすことでリニアに性能向上できることの方がはるかに重要だ。たとえ数百msのレスポンスで数十tpsになったとしてもトランザクション機能とスケーラビリティは必須である。

2つ目はセカンダリインデックス。
実はKVSであっても単純なkeyとvalueだけでなく高度な検索ができるようなものもある。例えば、GAEのDatastoreには、データがソートされて格納されている。そしてRANGE検索ができるため前方一致で検索できる。これはRDB(2次元)とKVS(1次元)の間の1.5次元の性質をもつというのだそうだ。(このあたりについては、kazunoriさんの記事:BigTableと分散KVS がとても参考になる)
キー検索以外にもプロパティ検索も欲しくなる。DynamoDBやAzure Storage Serviceでは、プロパティ検索は可能だが、GAEのproperty indexのような、Built-in indexが存在しないためプロパティ検索は全スキャンになってしまうようだ。これでは大量のデータ検索には使えない。


ReflexWorksにおける基本設計と検索について

元へ。クライアント開発では単なるJSON呼び出しなので、それほど苦労しないことは理解いただけたと思うが、サーバ側ではそれなりのサービスを準備するのが結構大変だと思われるかもしれない。だが、実はそんなことはない。以下に示すように、ReflexWorksはドキュメント指向でありORMは不要であり設計も単純明快だ。


ReflexWorksにおける設計の基本となるのはエンティティである。エンティティとは、簡単にいえば、一単位として扱われるデータのまとまりのこと。難しくいえば、貧血症をおこしたオブジェクトのこと(笑)。POJOでもJSONの連想配列でも何でもいい。とにかく、クラスやプロトタイプに複数の項目がプロパティとして付いているものをエンティティと呼んでいる。ただし、CSVのようにデータを列挙したものではなく、項目と値がペアになっておりまた親子関係も表現できる。

ReflexWorksでは、このエンティティにユニークなアドレス(URL)をつけることで、データ全体を階層管理している。そして、そのアドレスに対してREST APIで操作する。


BDBはセカンダリインデックスが使えるという(1.5次元の)KVSである。このセカンダリインデックスにより、様々なプロパティ検索やソートなどを高速に実行できる。

例) GET /d/{selfid}?{name}{=|.eq.|.lt.|.le.|.gt.|.ge.|.ne.}{value}&{name}{=|.eq.|.lt.|.le.|.gt.|.ge.|.ne.}{value}&...&l={n}


重要なことは、どんなに分散しても全体の階層管理は崩れず一貫した操作が可能になっているということ。RDBであればデータ量が増えるとテーブル分割などで頭を悩ませることになるが、ReflexWorksであればアプリはBDBのことを気にせず単にREST APIを実行すればよく、裏にあるノードの数なども気にする必要はない。

ReflexWorksにおけるトランザクション処理

トランザクションに関して説明する。
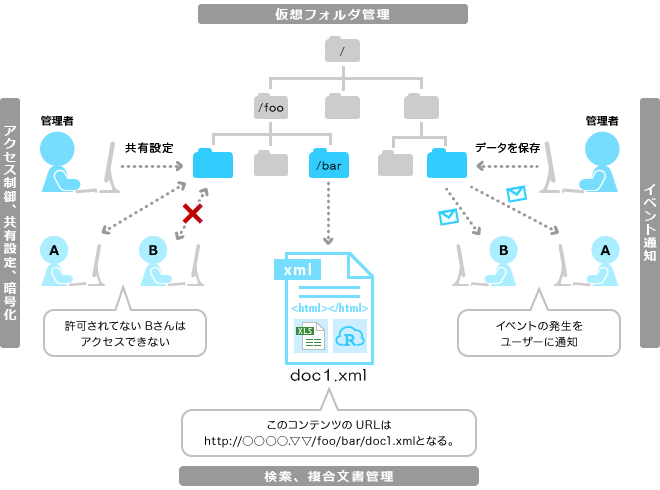
reflexworksでは、最小単位のentryにaliasという別名フォルダを複数付けることができ、またatomicな更新ができる仕組みを提供している。別名フォルダとは、/foo/doc1.xmlを/bar/doc1.xmlでもアクセス可能にする仕組みで、UNIXファイルシステムのシンボリックリンクだとおもっていただければ結構だ。


atomicity(原子性)、isolation(分離性)、consistency(一貫性)
  • (ATOMの)entryはトランザクションの最小単位であり原子性をもつ
    • つまり、RDBの1レコードに相当
  • alias(別名)の追加削除はentry内であるためatomicでありisolationが保たれる
    • 例えば、entryがフォルダ移動しても2重に見えたりはしない
  • 複数のentryはfeedで括られる
  • feedのPOST/PUTは1トランザクションで実行されるため、どれか一つでも失敗するとロールバックする(一貫性は保たれる)

例えば、本を買う例でいえば、本はカートに入れられるか、入れるに失敗するかでなければならない。あるいは、買うか買わないかである。


これは、フォルダをカートとみなせば、注文データ(Document)がフォルダ移動する問題に置き換えることができる。以下のように、異なるフォルダで同時に見えてはいけないし、どちらにもないという状態があってはいけない。


これを、reflexworksで実装すると以下のようになる。selfはこのドキュメントの実体があるフォルダを示す。(固定)一方のalternate(別名)のフォルダがfolder1からfolder2に更新されることで上記のフォルダ移動を実現する。entryの更新はatomicなので一貫性は保たれる。


最後に

KVS上でアプリを動作させるために必要なこととは、トランザクション処理とセカンダリインデックスの2つということを説明してきたが、あくまでこれはオンライン業務のアプリに関してであり、一貫性を必要としないような検索系のアプリなどは他のKVSを使ってさらに高速化できるだろう。あるいは、BDB以外でトランザクション処理とセカンダリインデックスをサポートするKVSがあるかもしれない。実はReflexWorksはBDBに特化したものではなく、他のKVS上でも動作するように、TaggingServiceとDatastoreはレイヤーを別けて作ってある。実際にGAE上でも動作するし、本当は、DynamoDBやAzure上でも動かしたいと思っている。 繰り返しになるが、ReflexWorksであれば、単純なRESTサービスのAPI実行になるため、下位のレイヤーがどのようなものになろうと開発者は意識する必要がない。また、こうすることでベンダーロックインを防ぐことにもなる。
 ちなみに、先日からFacebook上で開発案件を募集しはじめたので、あわせて紹介しておきたい。 


 ReflexWorksで分業開発をしよう! 
「HTML5や画面デザインなどをお得意とされている方は画面開発だけに集中し、サービスのことは考えなくて構いません。サービスの実装部分はJavaなので、サービス開発担当、もしくは弊社メンバーがお手伝いできます。お互いに得意なところを役割分担しながら分業開発できればいいなと考えています。」


金曜日, 6月 29, 2012

エンタープライズクラウドでも破壊的イノベーションを このエントリーを含むはてなブックマーク

昨日の記事はちょっとわかりにくかったと思うので補足したい。

RDB不要論

浅海先生よりコメントをいただいた。(ありがとうございます)

全くおっしゃるとおりで、「昔から普通にやってきたこと」で今でも大変有効な技術は多いと思う。ISAMやVSAMのKSDSにしても昔は実際にオンライン処理をやっていたわけだからできないはずがない。というより、もしかしたらRDBより向いているんじゃないか?というのが私の率直な印象。結局のところ、データの集計や分析では、わざわざRDBからデータ抽出してHadoopでバッチ処理するか、カラムナDBに入れ直すとかやっているわけである。実際、大規模トランザクションを処理するオンラインシステムでは「リレーショナル」機能はほとんど利用されておらず、まるでKVSのように使われているのが現状ではないだろうか。そう考えると、そもそもオンライン処理でリレーショナルは必要ないんじゃないかとさえ思えてくる。

それからもっと厄介なのがO/Rマッピングの件。オブジェクトの構造や関係性をリレーショナルモデルに効率よく変換できない問題(インピーダンス・ミスマッチ)があって、その結果作られた効率の悪いSQLが全体のパフォーマンスを劣化させてしまうという現状がある。
なので、やはり、O/Rマッピングなどの「癌」はアプリから排除すべきであり、そのためにはRDBではなくオブジェクトを直接ストアできるKVSを使うべきというのが私の意見である。それでやっと純粋にオブジェクトの世界だけでアプリを作れるようになるのだ。
 
また他方で、RDBはオンライン処理系から排除されてバッチ処理系の仲間になるわけだが、これは前述したとおり、カラムナDBにするか、いっそのことHBASEにしてしまうのがいいのではないかと思っている。そして、バックエンドのHBASEなどに対しては、今流行のFluentdを利用することで、うまくやれば、ほぼリアルタイムに更新可能になるかもしれない。ただし、データロスは許されないので信頼性の担保についてはもう少しよく検討する必要があるとは思うが。


これでいいのだ

データ操作と破壊的イノベーション

リレーショナル機能がないとしたら、データ操作をどうするかという問題が出てくる。RDBはなんだかんだいって、複合検索やソート、JOINといった、とても便利な検索が可能である。そして、これはアプリにとって大変重要で必要不可欠な機能でもある。

そこで、ツリー構造の仮想フォルダ管理とREST APIによるデータアクセスで解決することを考えた。実際にReflexWorksでは、以下のように、UNIXのファイルシステムのパスのようなイメージで直感的に操作でき、アクセス制御、共有設定、暗号化といった設定も可能である。例えば、GET /foo/bar/doc1.xml と実行すると、doc1.xmlを取得できる。(GETコマンドはリモートからのHTTPリクエストかローカルのAPIからのどちらからでも実行できる。また、doc1.xmlはATOM Entryを拡張したもので、様々な項目をユーザ自身で自由に追加できる。もちろんJSONも可能だ)ちなみに、GET /foo/bar とすると、barフォルダ配下のエントリが全てリストで取得でき、?item=hello* など、項目に検索条件を指定することも、前方一致検索、ソートなども可能だ。アプリで必要な機能はほぼ満たしており、リレーショナルを意識することなく、オブジェクトに集中して設計開発できるのは大変嬉しいところである。


RDB不要論とか偉そうに言っているが、実はこういった発想はGoogle AppEngineからいろいろ学んで得たものである。ひがさんの記事の破壊的イノベーションのような発想の転換があり、それから、コスト1/30でスケーラビリティの衝撃 で紹介したような実際にKVSで動作するスケーラブルなアプリが多数作られるにつれ、自信が確信に変わっていった・・。

CQRSとの比較

で、CQRSの話に移るが、恥ずかしながら、浅海先生から指摘されるまで知らなかった。
CQRSとは には以下のようにある。


CQRSは「Command Query Responsibility Segregation」の略語である。日本語で言えば「コマンドクエリ責務分離」もっと解りやすく言えば「更新処理と参照処理とに対する応答部分を明確に分離する」事である。構造としてSystemを次の四つに分類する。
  • Query(参照)
  • Command(更新)
  • 内部Event
  • 外部Event(公開Event)

これを読む限りにおいては、ReflexWorksはCQRSではないようである。
更新処理と参照処理はKVS内で完結するため分離ではなく同一である。KVS内であれば参照と更新を分けなくても高速に処理できる。どちらかというとRDBの負荷を軽減させるというよりRDBを無視して単独で動作するという表現に近い。また、MVCを否定しているわけではなく、MVCモデルは進化する で述べた以下の発想に基づいて設計されている。


ドメインサービスとしてのReflex BDB
Reflexの新3層アーキテクチャーにおけるドメインは、EntityのCRUD操作以外の何ものでもないのだが、登録変更削除においては、「外から何をされてもデータの整合性が壊れない様にすること」がもちろん保証されなければならないし、検索においては、単なるPKによる検索だけではない点は補足すべきだろう。例えば、PK以外のKeyによる検索、大小比較、全文検索、Pagingといった検索などについては、要求仕様に応じて、それなりにドメインロジックを実装しなければならない。 まだ公表する段階ではないのだが、Private CloudのソリューションであるReflex BDBの次のバージョンにおいて、単なるKey/Valueの検索ではなく、ドメインサービスとして機能するようなものを作っている。内部的にはBDBなのでKey/Valueではあるが、GAEのProperty Indexのような仕組みを追加することで、汎用的なKeyによる検索などができるようにするつもり。ちなみに、これはConsistent Hashと伝染プロトコルを使ったスケールアウトアーキテクチャーとなっており、Dynamoのようにそれぞれのノードを柔軟に追加削除できる。(予定)


この記事を書いたのが2009年10月で、完成してお客様事例になったのが2011年1月だから、まともに使えるようになるまで2年以上かかったことになる。現在、事例1 のお客様で
約100万件/日のトランザクション、約10万枚/日の伝票印刷を処理しているが平均500msのレスポンスを維持できている。(2012/10現在) 150万ops/日、99.96%が100ms以内のレスポンス
自分自身、その性能発揮ぶりに驚愕すると同時に、「クラウドを空想してあれこれ議論するよりも論より証拠。100の理論より1つの事例」ということをあらためて認識した次第である。

木曜日, 6月 28, 2012

エンタープライズクラウドにおけるスケールアウトの現実解 このエントリーを含むはてなブックマーク

企業のWebシステムの3-tierモデルでは、ロードバランサーを置くことで、複数のWebサーバとAPサーバに処理を分散させることが可能だが、ある程度の規模になると今度はDBがボトルネックとなりスケールしなくなる。 これを解決するにはどうすればいいのだろうか?ReflexWorksでは、DBMSに依存しないオンライントランザクションシステムの構築を可能にしている。そのポイントについて述べてみようと思う。

キャッシュ技術の限界

 DBMSのボトルネック解消手段としてよく使われるのがキャッシュ技術である。キャッシュ技術には、OSSのMemcachedや、JavaEE7のJCache、Oracle Coherence, WebSphere eXtreme Scaleといった商用製品などがあり、メモリキャッシュをAPサーバに置くことでDBのボトルネックを軽減させることができる。 なかには、トランザクションをサポートしているのもあり、読込だけでなく書込においても効果を発揮して、DBMSの負荷は大きく軽減できるようになる。

たしかに、キャッシュ技術を使うことで高速化(低レイテンシ)を実現できるが、一方で実は改善できるのは高速化した分だけ、という見方もある。頻繁に使うマスタ参照や数千tps以上といった大規模リクエストの緩衝機能として効果は見込めるものの、実際にキャッシュ読込のために最低1回はDBにアクセスしなければならず、永続化の問題(揮発性のためデータがロスする)やDBとの整合性の問題がある。また大規模なメモリが必要になるとコスト面でもメリットは少なくなる。つまり、キャッシュはあくまでキャッシュであり、リニアに無限にスケール拡張ができる技術とはいえないということである。

2008年当時、企業内クラウドは、最初は大手ベンダーによるキャッシュ目的で導入され、最後はアーキテクチャ変更をもたらす(参照)といったような楽観的な予測もあったが、いろいろ経験するにつれ、もう少し踏み込んだ発想をしないとブレークスルーはしないと私は考えるようになった。

主従逆転の発想

前述のように、キャッシュメモリをどんなに積んだって最後はRDBがボトルネックになるのは必然であり、これを解決するにはアーキテクチャー変更が伴うわけだが、だからといってRDBを否定してKVSで全部代用できるとは思えない。企業にはRDBのために特別に用意された耐久性に優れた高性能サーバが厳然と存在しており、今後もRDBがシステムの中心として君臨し続けることは間違いないからだ。Webの3-Tierアーキテクチャーも基本的には変わらないだろう。

しかし、オンライントランザクション処理に限っていうと、トランザクション処理とデータストアの分離ができれば、スケールしないRDBを必ずしも使う必要はなくなる。つまり、単にRDBをデータの格納場所として使い、オンライン処理の基盤としては別のものを使うことで、RDBがボトルネックになるのを防ごうという発想である。

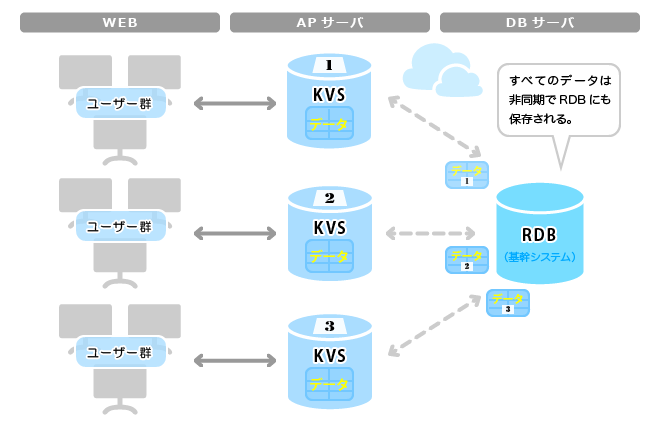
具体的には、キャッシュの発想をもう少し進化させたような感じで、APのKVS内だけでトランザクション実行を完結させ、RDBとはEventual に同期するような仕組みとすることで、RDBに負荷が集中することを防ぐ。参照系(マスタ、トランザクションのREAD)はRDBへアクセスしなくてもKVS内で実行できるようにする。要はKVSだけでアプリの実行(READ,WRITE)ができるようにすること。これを実現するには、KVSでアプリのデータ操作をすべて賄える必要があり、ACIDトランザクション処理を確実に実行できかつ永続性を備えることは必須となる。

1.マスタ等をKVSに配置する。参照(READ)はKVS内で実行しRDBに参照しにいかない。
2.  トランザクションの参照(READ)はKVS内で実行する。RDBに参照しにいかない。
3.  トランザクションの更新(POST,PUT,DELETE)をKVS内で実行して保存する。非同期に更新結果をRDBに送信する。


この図を見てもわかる通り、実はWeb-AP-DBの3 Tierのアーキテクチャーは崩していない。ただAPサーバ内にKVSというトランザクション処理基盤を導入しているだけである。(3Tierというだけで企業にとってはずいぶん敷居の低いものに見える)

だがこうすると今度はRDBとの整合性が問題になる。RDBはEventualに更新されるためタイムラグが発生する。例えば、実際にはKVSで既に注文を受け付けているのに、RDBではまだ受け付けられてない状態になっているかもしれない。

実はここが最も重要なポイントで、整合性※などが問題ないように、うまく設計する必要がある。(※ 整合性と一貫性はどちらもConsistencyの意味で使われるが、私は、オンライン処理などの同期処理において矛盾の無いことを保証する場合に一貫性といい、非同期処理においてデータに矛盾の無いことを保証する場合に整合性といっている。この使い分けが正しいかどうかはわからない。)

1点目は、遅延を許容すること
 正のデータは常にKVS上にありリアルタイムに更新されているが、RDBは若干遅れて更新されることを前提に考える。オンラインの範疇はKVSまでとし、RDBから以降はバッチ処理と割り切ることができるかどうか。ここはeventually consistencyというと語弊があるので、単なる非同期更新と考えてもらえればと思う。

2点目は、整合性を保証するプロトコルとすること
 データはレコード単位に(システム全体で)ユニークかつバージョン(リビジョン)管理する。また同じデータが複数ノードに散在している可能性があり、RDBを更新する際は何回更新されても同じ結果になるようにする(べき等性)
 さらに、あるノード上のデータがRDB更新前にダウンした際にも、KVSのログ等からコミット分を抽出してRDBに反映できること。(トランザクションリカバリー)


ReflexWorksでは、データはユニークなIDとバージョン(リビジョン)番号で管理されており、整合性は常に保たれる。もともとスマホやChromeのオフラインアプリなどでネットワーク分断があっても整合性を保つために導入した概念だが、APとDB間を含むシステム全体で整合性を保証することにも利用している。


月曜日, 6月 18, 2012

分散KVSにおけるスケーラビリティと一貫性の両立について このエントリーを含むはてなブックマーク

先日、容易なスケールアウト拡張とトランザクションの正確性を担保する分散KVS基盤、ReflexWorksを発表した。(http://reflexworks.jp/)
エンタープライズシステムの多くは強い一貫性が要求されるため、これまではRDBMSを使うことが多かった。しかし、簡単にシステム増強できないことから、増え続けるデータに柔軟に対応できないという欠点があった。
分散KVSは、単純なキーとバリューのデータからなるデータストアを複数のマシンに分散配置したものである。これをデータストアにすることで、システム稼働後であってもサーバー資源を動的に追加できるなど、柔軟なスケーラビリティを実現できる。

ReflexWorksは分散KVSにBerkeley DB Java Editionを採用、システムをスケーラブルにしつつ、同時にトランザクションの正確性を担保しており、大規模なトランザクション処理が求められる企業システムの構築を容易にする。

ReflexWorksはスケーラブルな企業システムを構築するための実用最小限の製品(MVP:Minimum Viable Product)である。

スケーラビリティと一貫性の両立について

CAP定理を勉強している方々は、スケールしながらトランザクション処理の正確性を担保するといった、ReflexWorksの特長に違和感を感じられるかもしれない。

クラウドの多くは「ScalableでAvailableで、かつ、Eventually Consistentなシステムは可能である。」というように、Consistencyの部分を緩くすることで実現しようとしてきたが、3つを同時に満たすなんてことは不可能というのがCAP定理の原理の原則のはずである。

ReflexWorksでは、容易なスケールアウト拡張とトランザクション処理の両立は実現しているが実はAvailabilityを若干緩めている。実際にノード障害があってフェイルオーバするまでの間は多少の停止時間があり、また、マスター更新の際は各ノードの同期を取るために運用を停止したうえで実行しなければならないなどの制約がある。

つまらん お前の話はつまらん


まあ、少し待ちなさい。
実際の運用で大事なのは、MTTR(Mean Time to Repair)つまりどれだけ早く復旧できるかである。
ReflexWorksは、特定のノードが故障するとシステム全体がダウンするような単一障害点はなく、サービスの継続利用が可能な仕組みになっている。また、障害により担当ノードにアクセスできなくなった場合でも自動的に他のノードに引き継がれるため障害の影響は部分的であり、(再ログインは必要になるものの)ユーザ単位にリストアするため数分程度で復旧できる。実際の復旧時間で比較すればRDBのフェイルオーバよりも短いかもしれない。

Cloud = Scalability + Consistency!?

ミッションクリティカルな企業システムでは、非常に高い可用性が要求されるのは当然なのだが、何よりも重要なのはデータの一貫性であって、AvailabilityをとるためにEventually Consistentなシステムにするというのは本末転倒である。かねてより、Eventually Consistentはナンセンスだと主張される方もいらっしゃったが(スケールアウトアンチテーゼ)、実際に一貫性を緩くするのはビジネス的に受け入れられないケースは多い。

ビジネスだけではない。以下の事例を見れば、コンシューマ向けWebサービスにおいても、一貫性は大きな課題であることが伺える。

twitterがHBASEを選択した理由の一つがシンプルな一貫性モデルであったこと。
Facebookが新サービスの基盤にしたのは、MySQLでもCassandraでもなく、HBaseだった


Instagramがスケールさせてきた際に一貫性問題が発生していたこと。
「バックエンドの経験はなかった」Instagram創業者は、どうやってシステムをスケールさせてきたか
クラウド = 「Scalability + Availability」といわれた時代もあったが、今後の主流は「Scalability + Consistency」、つまり、スケールさせつつ、どうやって一貫性を保証するかが重要になっていると思う。

スケーラビリティの実現手段

ReflexWorksが実現しようとしていることとは、容易なスケールアウト拡張と一貫性の両立である。では、可用性を緩めさえすればこの2つは両立できるのだろうか。

実はそんなに甘くない。

サギー

まあ、少し待ちなさい。
実際のオンラインシステムでスケールが必要になるケースというのは、多くの場合はユーザ数増加などによる負荷増大が原因である。それであればユーザID単位のシャーディング(分散配置)で解決できる。1ユーザあたりのデータ量の大きさが問題になる場合は利用期間や容量制限などで解決すればよい。

このシャーディングの考え方は特別に新しい技術ではないがとても実用的である。
Salesforceのマルチテナントアーキテクチャーにおける組織IDであったり、先ほどのInstagramのスケール化でもシャーディングで解決しているそうである。


ReflexWorksにおいてもユーザID単位でのシャーディングを基本としており、ConsistentHashアルゴリズムにより担当ノードを決定する。一度担当ノードが決まれば基本的にそこだけアクセスすればよく、ユーザ数が増えて処理能力が足りなくなったら単純にノード追加すればよい。


ただし、他ノードのデータを参照したい場合はリモート呼び出しで対応する必要があり、この場合はACIDは保証されない。「容易なスケールアウト拡張と一貫性の両立」といっておきながら分散トランザクション処理ができないなんてイミフwww、と思われるかもしれないが、複数ノードに跨がった更新処理はパフォーマンスのことを考えたらやるべきではないし、これを許してしまうと密結合の世界に誘導してしまうことになりかねない。

とにかく、疎結合であることは重要。密結合になってしまうと絶対にスケールしない。

分散トランザクションがなくても、実際にはユーザのグルーピング機能などを使って同一ノードに配置するなどの代替案で対応できると思われるので、本当に分散トランザクション処理が必要なのか設計の段階でよく検討すべきところではある。

その他、ReflexWorksでは、サーバはデータを返すだけでクライアントでページを動的に生成したり、帳票印刷といったような重い処理をクライアントで実行したりと、サーバの負荷軽減のための工夫が随所でなされている。単なるシャーディングだけではなく、疎結合を基本に全体的にサーバ負荷軽減がなされるようなアーキテクチャーになっている。


月曜日, 3月 12, 2012

はてなブックマークボタンを外しました このエントリーを含むはてなブックマーク


はてなブックマークボタンを外した。ついでにはてなスターも。
http://www.nantoka.com/~kei/diary/?20120312S1

ツイートボタンとか、いいねボタンとかまだあるけど、もしかしたら何か悪さしている可能性を否定できないけど、とりあえず、はてなは外すことにした。

それから、Google AdwordsAdsenseも外した。

こいつも情報を収集しているそうだが、ここを見ても、どのようにサイトポリシーを書けばいいのかわからなかった(「プライバシーポリシー変更の詳細についてはこちら 」のリンクが切れている)

とりあえず言えることは、サイトポリシーを書かないでGoogle Adsenseを表示させるとまずそうだということ。
たぶん、はてブボタン設置と同じ罪になると思う。(でもサイトポリシーを正しく書けば大丈夫そう)

ちなみに、Google Analiticsを使っている表記だけはしてある。
はてなブックマークボタンを非難してる輩はAdsenseも要注意。

<追記>
3/14
はてなの日記が出たので元に戻した。
はてながどうというより、本サイトに訪れる人の行動履歴が勝ってに収集されず、第三者にも渡らないのであれば、それで十分だと思うからです。Adsenseは戻したくないので戻しません。

月曜日, 3月 14, 2011

【人財募集】 あなたもSuperになって このエントリーを含むはてなブックマーク


 ぶいてくでは人財を募集しております。2011/3~2012/3の長期プロジェクトです。

案件概要


 Reflex Tagging ServiceやReflex BDBを使ったSI案件で、設計モデルはVTECメソッドです。これについては以下の記事に詳しく書いています。

 そろそろMVCモデルについて一言いっておくか

必要なスキル


  以下のうち、いずれか。何か強みがあればOK。 

 ・ HTML/JavaScript(jQuery)
 ・ Flash(Flex4)
 ・ Java
 ・ RDB


 それから、
 あなたはSuperになるべきだを読んで共感できる方。

 首を長ーくしてお待ちしております。m(_ _)m takezaki あっと virtual-tech.netまでお願いします。

月曜日, 1月 17, 2011

【Google App Engine】 app engine ja night もう、戻れません!(#ajn13) このエントリーを含むはてなブックマーク


 ajn13では大規模事例ということでバスキュールさんの「mixi X'mas2010」と「the Actress」の話があった。

コスト1/30で無限スケーラビリティの衝撃


 クラウドを空想してあれこれ議論するよりも論より証拠。100の理論より1つの事例。

mixi X'mas2010 (詳細はtogetterや、kazunori_279さんの記事を参照)

* 登録者数275万、ピーク時の最大風速620req/sec。ただし上限(limit)については最初からGoogleに相談済み。
* 2200万-2500万req/日くらい。420インスタンス、を目撃した。ただし、このリクエスト数に静的リクエストは含まない。
(またflashのダウンロードなどあるので、そこはAWS CloudFrontを使ったり、ちゃんと使い分けている)
* 12/1-24までのリクエスト総数5億3千万ほど。データストア95GB、レコード数2億件程。
* 開発期間は2ヶ月くらい。実装は1ヶ月*一人。WebAPI*20 モバイル画面*50 


 バスキュールさん曰く、「今までは面白いことをたくさんの人を巻き込んで大規模にやろうとしても初期コストが問題になっていたが、appengine で初期コストを気にせずできるようになった。」とのこと。
 「大体、1000万リクエスト=100ドル!インフラの桁が1個違う。もう戻れない」
 個人的に聞いたところコストは約1/30で済むとのことだった。30%ではなく1/30!私はこれを聞いて電撃的ショックに見舞われて真空状態に陥った。
 (広告でもよく見かける「クラウド導入で30%コスト削減」とか、そんなのは鉛筆舐めて工数叩いてやってるだけのエセクラウドなんですよ。逆に、GAEが本物のクラウドだという証拠でもある。)
 しかも、オートスケールが素晴らしい。2200万req/日のシステムというだけでも相当難易度の高いシステムが要求されるはずだが、GAEは「mixiクリスマスはたった二日半で100万ユーザ、一週間で200万ユーザ。2200万req/日。想定していない数字だったが涼しい顔でスケールアウト」
 こんなの、LAMPで作れる自信はありません。

 これを一人で作って、しかも、開発期間は2ヶ月くらい。実装は1ヶ月*一人、運用まで全部やるなんていうから、これまでの常識では到底考えられません!!

 たしかに、実際の開発では、大規模システムのための高いスキルやノウハウが必要とされ、GAEという特殊環境のなかでチューニングをやっていくのは大変だと思う。
 だが、それらを乗り越えられる者だけが、これまでの常識では到底考えられないような、スケーラビリティとコストメリットという果実を得ることができる。

 今後はさらに、この全く新しいパラダイムが加速されて広がっていくのは必定で、無限のスケーラビリティ、コスト1/30に古い世界が駆逐されていくのは火を見るより明らかだ。そうなるのは、もう時間の問題である。
 その新しい舞台にで生き残っていくためにも、私たちはGAEは必須と考えて、スキルノウハウの蓄積やソフトウェア開発を惜しみなくすすめていく必要があると思っている。

大規模リクエストを処理するためのテクニックについて


 大規模なリクエストを処理するには、GAEといえども、様々なチューニングを必要とする。
 こういったテクニックやノウハウはajnだからこそ得られる大変貴重なものだ。(運営者の方々、感謝です!)


* 設定情報をstatic変数に保持し、Memcacheへのアクセスを減らすのが効果的。static変数に有効期限を設ければ、全インスタンスに行き渡らせることができる。
static変数-(期限切れor価なし)->Memcache-(価なし)->Datastore の順にアクセス

* mixiの10秒制限対策(millisec/reqのグラフで、普段は数百msなのにたまに數千msかかるタイミングが集中する事がある)では、datastoreのdeadline設定を行う
(DatastoreServiceConfig でDatastoreのタイムアウト時間を設定できる。datastoreのdeadline指定は、今のところ全てのアクセスに対して行ってる。クエリの種類などに応じて制御はしてない)

* 「query よりbatch getを優先」→これは #appengine で超重要
* カスタムインデックスとマージジョインは使用しなかった。カスタムインデックスが作られないと怖いので。十分に検証する時間がなかったため避けた → 現在のバージョンであれば大丈夫。
マージジョンはデータ件数が多いと効かなくなる。→ 現在のバージョンでも変わらないので、カスタムインデックスを作ることで対応する
* 規模が大きいためTQの利用を限定的にした。→ TQのQuotaはDatastoreと共有なので、設定ファイルに定義できる。(解決可能かもしれない)
* エンティティのキーの先頭にタイムスタンプをつけてた→特定のタブレットにアクセスが集中することでタイムアウトエラーが発生しやすくなった→ハッシュ値をつけてエンティティの分散を行った
* メモリ使用量問題への対策:1リクエストでの処理を減らす。モジュールのロードを減らす、使用頻度の低いものは極力ロードしない。変数によるキャッシュを減らす
(メモリに一度に取得するのではなく、非同期get/putとIteratorを使うことで、30%のパフォーマンス改善を見込めるとのこと。V1.4以降)


現状の課題について


 現状の課題について、気になったところをピックアップしてみる。


* アクセスが多い場合にログが全部取れないという問題がある。名前はいえないが、現地のとあるGooglerによれば、解決する作業は始めてはいますよとのこと。今後に期待したい。
* 複数のappidが連携するアプリを構築したら利用規約に違反するという問題。→ 複数appidを使って無料クオータを使うような悪質なものでなければOK
* バージョンアップ時のSpinup問題(spinupが猛烈に発生して、スケールアウトが間に合わなくなりそう) → うーん。
* セキュリティ(個人的に会話した部分):個人情報などを格納できないので、他のサービスを使わざるを得ない。
 フラッシュマーケティングなどでクラウドに置く事例も出てきてはいるが、問題解決していないまま使っているケースであり、かなり危険(赤信号、皆で渡れば怖くない状態になっている現状)


 最後に、appengineは劇的なスピードで機能追加・パフォーマンス改善が行われてる。夏と今で比べてもかなり違う気がする。過去断念した人ももう一度トライしてみよー。
GAEは、ソーシャルアプリに向いてる!gae/j+slim3+eclipseの生産性が素晴らしい!

月曜日, 12月 27, 2010

【Google App Engine】 勝手にAzureと比較して質問に回答 このエントリーを含むはてなブックマーク


 前の記事のなかのAzure Table StorageとGAEの比較について、割と普通さんより質問があった。
 断っておきたいのは、私自身、AzureとGAEについての知識の温度差はあるものの、(というかAzureはほとんど知らないが)、GAEを持ち上げAzureを蔑むような気持は毛頭ないということ。逆に、Azureについては、私はエンタープライズ向けPaaSでは唯一の選択肢と考えており、現在提案中の案件を含め、いろいろと勉強していかなければならないと考えていること。
 そういう意味で、このように質問をいただけるの非常にありがたいと思っている。
 とはいえ、Azureを調べた第一印象では、GAEの方がAzureより使い勝手がいいと率直に思っていることは事実であり、GAEびいきになっていることをご容赦願いたい。それから一問一答という形ではなく、具体的にAzureで困ったことを元に、property検索、トランザクション、スケーラビリティとパフォーマンスという形でまとめているので悪しからず。多分、回答としては網羅しているとは思うので、全体を通して読んでいただければ幸いである。
 また、間違いはあると思うのでいろいろ突っ込み願いたい。


割と普通と申します。

Azure Table StorageとGoogle BigTableについて、それぞれ疑問点があるので質問させて頂きたいと考えています。
私の勘違いでしたら申し訳ありませんが、「Azure Table Storageは他のクラウドサービスよりも機能不足」と認識
されているのではと考えましたので、ご一考頂ければと考えています。

・Azure Table Storage
 -Entity GroupによるトランザクションはTable Storage側でも実行できると思います(EGの意味がGAEと異なりま
  す)。どこかの資料で「Table Storageではトランザクション処理はできない」という記述がありましたでしょうか。
 -SQL Azureの提供は既存資産互換のためですが、BigTableに対応するものはTable Storageだと考えて頂きたいです。
  逆に、現時点でGAE側にSQL Azureに対応するものはありません。何をもって「スケーラビリティをないがしろに
  している」とされているのかが理解できませんでした。
 -GAE側でも「「破壊的イノベーション」の痛み」は間違いなく伴うと考えていますが、私の認識違いでしょうか?
  「GAEと比べても相対的にAzureは設計思想のギャップが大きい」と言われているのか、純粋「にクラウドサービ
  スなので設計思想のギャップが大きい」のかが理解できませんでした。

・Google BigTable
 -BigTableはCountが取得できるのでしょうか。私が調べた段階では効率的な取得方法が存在しなかったのですが、
  「全件データを一旦取得する」等の方法以外がBigTable側で提供されているのでしょうか?
  ※Azure側でも「見た目上はCountを実行する処理」は書けますが、分散KVSの特性を生かすためにはCount用のテ
   ーブルを作成する必要があります
 -Table Storageでも「前方一致検索や大小比較を含む検索が可能」は可能だと考えていますが、LINQのWhere関数
  等を利用した処理では意図された処理しては不十分でしょうか?
 -「PartitionKeyのように物理的な配置をアプリケーションで意識する必要がない」は、意識したくなければ意識す
  る必要はありません。データ検索の速度を向上させるために与えられた設計パラメータです。逆にGAE側では「物
  理配置を意識することなく、常に高速な検索が可能」という事でしょうか?
  ※以下の記事を通読していたので、疑問に思っていました
    http://agilecat.wordpress.com/2010/05/29/%E3%83%A1%E3%82%B8%E3%83%A3%E3%83%BC%EF%BD%A5%E3%82%AF%E3%83%A9%E3%82%A6%E3%83%89%E3%81%AE%E6%AF%94%E8%BC%83%E3%83%86%E3%82%B9%E3%83%88-part_1-%EF%BC%9A-%E6%80%A7%E8%83%BD%E3%81%AF-amazon-s3-%E3%81%A8/
 -「batch get/batch put」の処理ですが、同じくAzure Table StorageのEntity Group Transactionでは不足でしょ
  うか?


また、SLAについての言及がなかったことが気になりました。Azure側では99.9%~99.95%のSLAを保証しておりますが、
GAE側は現時点ではSLAを提示していません。その辺りもご考慮頂ければと考えています。


具体的にAzureで困ったこと(property検索)


 おっしゃる通り、私はたしかに、Azure Table StorageはGAEよりも機能不足と感じている。その点について説明したい。

 まず、Azureを提案するにあたって、拙作のReflex Tagging Serviceの移植を考えた。これは、統一したEntityモデルと共通のREST APIによる高い可搬性をウリにしており、一度アプリを作ってしまえば、GAEだろうとどこでも動くようにできるフレームワークである。(つまり私たちにとって重要なのはAzureやGAEではなくReflex Tagging Serviceが動く環境なのかどうかである)

 ところが、いろいろAzureを調べていくと致命的な課題が見えてきて、結局のところ移植を諦めざるを得なかった。

 例えば、property検索については、LINQのWhere関数は確認できたものの、INDEXが内部的に張られるかどうかわからなかった。Indexがなければ全走査になってしまうので、パフォーマンスを考えると対象件数がおのずと限られてくる。
 Tagging Serviceでは、例えば、/foo/bar のentityについては、_parent=/foo , _selfid=barというような持ち方をしている。(_parentや_selfidはproperty)
 このようにproperty検索を基本としている以上、INDEXのあるなしは、パフォーマンスやスケーラビリティに大きな影響を及ぼすことになる。

 property indexを自前で作ろうと思っても、データとindexをatomicに更新する問題が残っている。index更新は、atomicか、あるいは、遅延更新で一方向であっても構わないが、データとIndexをentity groupにすることはできないため、確実に更新する術はないと思われる。

具体的にAzureで困ったこと(トランザクション)


 トランザクションを考慮すると問題はもっと複雑になる。Entity Groupを考慮したKeyの設計をどうするか。

 例えば、先節で指摘したindex更新の件もそうだし、以下のような3階層のEntity GroupにおけるAncestorQueryの結果など、そもそもAzureでは実現困難に思える機能もGAEにはある。


Person(1)をルートとして、Person(2)とPerson(3)をひとつのエンティティグループに設定する場合、 Person(1)/Person(2)/Person(3)とすることもできるし、Person(1)/Person(2)、Person(1) /Person(3)とすることもできる。

両者はAncestorQueryによる取得の際に結果が異なってくる。・・app engineのエンティティグループ


 とはいえ、実は、私たちは3階層のEntityGroup設計を否定しているので、ここでは強く主張しないことにする。

 これ以外で使いづらいと感じたのは、PartitionKey。特に、物理的な配置をアプリケーションで意識しながら設計しなければならない(と思った)こと。これは、トランザクションが絡むとなおさら難しい。

 Tagging Serviceのkeyについては、親キーが/foo/bar、子キーが/foo/bar,0(数字はrevision)という持ち方をしている。Revisionを付けているのは履歴を保存するためだ。

 また、/foo/barに対して複数の別名(alias)が付けられるが、alias /hoge/fugaについては、親キーが/foo/bar、子キーが/hoge/fuga,0という持ち方をしている。


 親キーを同一にしているのは、original(/foo/bar)とalias(/hoge/fuga)でatomic性が要求されるからであり、entity groupとして括る必要があるからだ。検索においては、aliasの親キーを指定してancestor queryを使うことで、関連するすべてのentityを1発で取得できる。更新時にはトランザクション制御が利くのでatomic性を維持できる。

 さて、これをAzureのTable Storageに当てはめるとどうなるだろうか。

 Azureのentity groupは、Partition keyで括るらしい(参考)ので、親キーはPartition keyとし、子キーをRow keyとする。よって、Partition keyに、/foo/bar、Row keyに、/foo/bar,0や、/hoge/fugaなどを付けることになる。

 問題は、冒頭で述べたように、データ検索の速度を向上させるために与えられたとされるPartition keyの意味が設計を難しくさせていることである。
 entity groupとして括るためにPartition keyを同一にする必要がある。ところが、もっと高速化するためにPartition keyに他の親キーを入れてしまうと、今度はentity groupの粒度が大きくなり、同時実行性能が下がるといった問題が発生する。(詳しくは次節)
 また、ancestor queryにしても、GAEでも内部的にはDatastoreのRange Scanが実行されているのでrow keyの前方一致検索で代替できるとは思うが、高速化のためだけに挿入したデータが混ざっていると具合悪い。

 このように考えていくと、「データ検索の速度を向上させるために与えられた設計パラメータ」という説明は適切なのかどうか。また敢えてPartition keyとRow keyを分ける必要性があるのかどうか。逆に、データ検索の速度を強調するあまり、Key設計をとても難しくさせているんではなかろうかと思った次第である。
 ちなみに、Datastoreでは、同一エンティティグループ所属エンティティは、100%そうなるとは限らないが、同じマシンに存在する可能性が高いらしい。しかし、検索の高速化のためにEntityGroupで括るといったような発想はしない。

具体的にAzureで困ったこと(スケーラビリティとパフォーマンス)


 階層の親子関係(例えば/fooと/foo/barや/foo/bar/baz)については、entity groupの対象とはしていない。もし対象としてしまうと、ルートがすべての親になってしまい、entity全体がロック対象となって、同時実行性が著しく低下してしまうことになるからだ。

 また、/foo/bar/bazのアクセス時には、/foo/barや/fooなど親階層すべてのACLを取得してアクセス権限を調べなければならないが、これにはBatch GETを使用することで高速化を図っている。Batch GETでは、GAE内部においてRPC通信コストが発生しないため、1件づつ実行するよりはるかに高速である。(ちなみに、このBatchGET/BatchPUTのようなDatastore側(AzureでいえばTable Storage側)でまとめて処理をすることで通信コストを下げるような機能はAzureには見当たらなかった。)

 各entryのcountについては、初期のバージョンにおいて、shared counterを使って自作していた(関連記事)が、現在のバージョンでは、countEntities()に制限はなくなり、約10万件を1秒そこそこで実行できるようになった。(参考:Google App Engine1.3.8のcountもlimit付けるとやっぱり超速くなりました)

 そもそも、shared counterのようなボトルネックを伴う設計はやってはいけない。Entity Groupの粒度を極力小さくして、同時実効性を高くすることこそが、パフォーマンス向上のための鉄板だと私は確信している。

 同時実効性さえ高ければ、一つ一つの処理速度は遅くても大量のデータ処理を短時間で実行できる。例えば、Datastore PUTは、理論値で20TPS(50ms/ transction)である。Entity Groupで括るとさらに遅くなり、秒間8から10が限度といわれている。しかし、エンティティを取得するタスク(Splitter)とエンティティをバッチ処理するタスク(Mapper)を分けることで、47,000件のbatch putを16秒で処理
できたという事例もある。

 逆にこういった工夫をしないで単純比較すると(秒間8から10なので) 質問で引用されている記事のような結果となってしまう。
 一言付け加えておくが、これは当然の結果とはいえ公平ではない。GAEとAzureを公平に比較するとしたら、SQL Azureではなく、Table Storageとの比較をすべきだろう。


Thus, in the case of AppEngine, we used the offered transaction model inside an entity group. However, it turned out, that this is a big slow-down for the whole performance. We are now in the process of re-running the experiment without transaction guarantees and curios about the new performance results.


 繰り返しになってしまうが、私が強調したいのは、単発の処理性能ではなく、Scale Outすることで全体のパフォーマンスを向上させることができるということ。当然、Auto Scaleは必須だし、Spin up時間などはパフォーマンスに含める必要があると考えている。その点、AzureはAuto Scale機能はなく、Management APIでインスタンスを増やした際に十数分かかってしまうのは致命的だと感じている。

最後に破壊的イノベーションの痛みについて


 現時点でGAEにはSQL Azureに相当するものがない。個人的には、少なくとも、スケールしないRDBは必要ないとは思っている(※)が、GAE4Bが出るまでは、SQL Azureとは比較できるものはない。

 (※ RDBはクラウドの世界では禁断の果実。きっと大いなる罠になると思っているので、GAE for Businessは出ない方がいい。)

 もちろん、RDBはRDBで進化を続けていて、無限に拡張できる(本当かどうかは知らないが)IBM purescaleや、75万QPSを実現したMySQL+HandlerSocketといった技術もあるのは承知している。ただ、MAX50GBなんてのは論外である。

 でもいざ作るとなると、Tagging Service程度のものであっても、RDBに比べたら大変なわけで、「破壊的イノベーションの痛み」はある。これはあくまで個人的な印象だが、GAE Datastoreであれば、Tagging Service程度であれば割と楽に作れるとは思う。

 イノベーションの痛みについて関していえば、少なくともajnに集うような濃い連中であれば、痛みを全く感じてない(ように見える)。私から言わせれば、一見うさぎに見えて竹やぶの中を全速力で突っ走る犬である。血だらけになって痛そうだけど本人は全く気にしていないようだ。

 でも、Azure Table Storageで作ることはとても辛いと感じるだろう。少なくとも私はできないと感じて諦めた。そういう意味で、AzureがやらなければならないことはGAEより多いはずだ。
 こと、Table Storageに関しては、SQL Azureに比べて日が当たらないというか、進化が遅々として進まない気がしている。提案も何かに付けてSQL Azureが中心である。
 それから、私が知らないだけかもしれないが、Key/Valueに精通した技術者が少ないのも気になる。こういう面をすべて含めて、スケーラビリティを蔑ろにしているんじゃないかと感じている次第である(気分を悪くされた方がいたらゴメンなさい)

 最後にSLAについて。


 Azure側では99.9%~99.95%のSLAを保証しておりますが、
 GAE側は現時点ではSLAを提示していません。


 これは全くそのとおりであって、GAEの信頼性が低いことは、実際に経験してみるとよくわかる。ビジネス向きではないのは明らかで、Azureと比べるまでもない。

日曜日, 12月 12, 2010

【クラウドコンピューティング】 クラウドごった煮で聞いて各社比較検討 このエントリーを含むはてなブックマーク


昨日、クラウドごった煮というイベントが開催された。cloudmix

Google、Amazon、SalesForce、Microsoftの4強+Niftyの、豪華面子でタイトルの通りごった煮にふさわしい感じの内容となった。どれもこれもHOTな話題で、正直、外の人も、おいつけません。 ><; 

(おっと、Herokuを忘れてた)

Amazonの圧倒的な競争力が印象に残った


Niftyクラウドは、国内にiDCがあり、Amazon互換のAPIがあり、人手が不要(API。そして、何といってもU/Iが秀逸である。ただ、強烈な競争力をもつAmazonなどに比べると将来性に不安があるのは拭えない。

Amazonは、無料、1円クラウドからスパコンクラウドまでLine Upを揃え、ストレージについても値下げをどんどん進めている。S3は最安で$0.083/GB/月であり(料金表)Niftyクラウド(11,000円/100GB/月)の約半額で利用できる料金だ。
(ちなみに、AppEngineやAzureは$0.15/GB/月である。)
機能面でも、Niftyクラウドは1ユーザにつきMAX5TBの制限があるが、Amazonでは1ファイル5TBデータをUpできるサービスもあるなど差は大きい。

これで、国内iDCが登場したらどうなるだろうか。

Amazonが安いのは、規模の経済+範囲の経済があるからだと小島さんはいう。AWSは、データセンターやコンピュータリソースはECサービスとは、まったく別のものであるが、共通の調達と運用ノウハウ(範囲の経済)が存分に生かせている。


これはNiftyクラウドに限った話ではなく、クラウドの流行に便乗してホスティングを始めた国産クラウドベンダーすべてに当てはまることだと思う。彼らが熾烈な値下げ競争にさらされたときに、果たしてそれに耐えうるだけの競争力があるのかどうか、ちょっと心配である。

Azureは.Netユーザの心を鷲づかみ。でもスケーラビリティに難あり


Azureの売りはやっぱりクラウド+オンプレミスのハイブリッドだった。

クラウドにおいても、既存のproperty(資産)を最大限に生かしつつ、利用者にとってこれまでのWindows環境とまったく同じイメージでクラウドを使えるようにする、あるいは、クラウドを使っていることを意識させないようにする、ということに最大の関心があるようだ。

Windowsの歴史をみてもわかるように、MSはとにかく下位互換性に相当気を使ってきた。それが開発者の支持を得て、OS2を打ち負かすことにつながった。今回も同様に、.Netサポーターへの配慮を最優先するというMSらしい戦略が背景にあるようである。

ただ、SQL Azureの50GB問題を抱えてもなお、オンプレミスとのシームレス環境を提供しようとしていることで、肝心のスケーラビリティを蔑ろにしている感もある。SQL AzureとKey/ValueのAzure Storage Sericeとの間には大きな設計思想のギャップがあるため、これを乗り越えるには、「破壊的イノベーション」の痛みが伴うはず。

例えば、Azure Storage Sericeでは、PartitionKeyとRowkeyの2つのKey検索しかできないため、SQLを使って複雑な検索処理を行っている業務アプリを移行するのは至難の業である。

果たして銀の弾丸のようなソリューションが出てくるかどうか。これからのAzureに期待したいところだ。

SalesForceはOpen化を加速。生産性の高さ、信頼性に一日の長


Appforce に加えて、Siteforce、ISVforce (AppExchange)といったものが発表されオープン化を前面に出してきたSalesForce。クラウド上で使える企業向けのRDBに近いモデルを REST や SOAP アクセス可能にしたdatabese.comなど、オープンでかつ魅力的なサービスも増えてきている。

SalesForceのすごいところは、雲の向こうですべてをやりきる姿勢を貫いている点。中途半端なことをしないところはさすがSaaSの雄である。

また、クラウドにデータを預けるには大きなリスクが伴うが、SalesForceはこれまでの実績を武器に、安心・安全なSaaS環境を提供できている点もすばらしい。

ちなみに、Azureについては、エンタープライズなどで培った技術という安心感はあるものの、前述したようにハイブリッドを薦めているおり、個人情報の管理にしても保障しないという前提のようである。つまり、完全なクラウド化にはリスクが伴うことを承知しているわけだ。

AWSにしても、 PCIサービスプロバイダ(レベル1)認証など、信頼性はかなり向上させてきてはいるが、実際のロードバランサなどのトラブル対応を聞く限り、安心感というところまでには至っていないようである。

AWSにしてもGAEにしてもAzureにしても解決できていない難問を、当然のように解決している点はすばらしいと思う。

Google App Engineはクラウドの王道を驀進する


GAEの最大の特長はなんといってもスケーラビリティである。(佐藤さんの資料)

特に、リクエストの量に応じてサーバのインスタンス数も自動的に増える(AutoScaleする)という点が大変すばらしい。単純な規模の話だけではないのだ。また、本当に使いたいときだけインスタンスが起動するから利用料も圧倒的に安い。

AutoScaleについては、実は、AWSのCloudWatch、RightScaleがあるし、AzureにしてもManagementAPIを使ったサードベンダー製品はある。ただし、実行環境のVMインスタンスがコピーされるため起動に数分~数十分はかかる。一方、GAEであれば、プロセスだけが起動するため長くて数十秒、WARMUPオプションを使用すれば実質0秒である。

ただ、GAEでは、スケーラビリティを考慮するために、Key/ValueストレージであるBigTableにデータに特化したアプリを作る必要がある。当然、実行時間やパケットサイズなどの制限もある。 ユーザアプリは、こういった特殊で制限された環境に特化したものを作らなければならない。

GAEは、このようなスケーラビリティとのトレードオフがあるため、受託には向いてないといわれる。クライアントの要望を断れないのはリスクが高すぎるのだ(by ひがさん)

また、Azure Storege ServiceとDatastoreを比較した場合、同じKey/Valueストアでも、ずいぶんと使い勝手がいい。


* property indexがあるのでkeyだけでなくpropertyの検索が可能
* custom indexを付けることで前方一致検索や大小比較を含む検索が可能
* PartitionKeyのように物理的な配置をアプリケーションで意識する必要がない
* EntityGroupによりトランザクションを実行できる。
* AncestorQueryにより、関連レコードを一括で高速に検索できる
* countを取得できる
* batch get/batch putができる


金曜日, 11月 19, 2010

【Google App Engine】 Prerelease SDK 1.4.0 is out!! でもちょっと残念 このエントリーを含むはてなブックマーク


 GAEがとうとう1.4.0になった。

Prerelease SDK 1.4.0 is out!!

 メジャーバージョンアップということだが、どこが目玉なのか、個人的に思うところを
挙げてみる。

1)インスタンス維持&Warmup Request
 これで、GAE最大の不満、SpinUp問題を解決できるようになる!!ところで、Warmup Requestは、これとセットと考えていいのだろうか。でも、常時実行というのは、技術的な解決策を期待していただけにちょっと残念。

2)Channel API機能
 Push技術はリアルタイムWeb時代になくてはならないものだ。Cometなのがちょっと残念。

3)TaskQueue/Cronの実行時間が最大10分に
 おおおお!やっときたか。リトライ条件を指定できるのも嬉しい。でも、Datastoreと通常のリクエストが30秒のままなのがちょっと残念。

4)Metadata Queries
 これが何なのかどうやって使うかわからないのがちょっと残念。

5)URLFetchのレスポンスが最大32MB
 10秒で返さないといけないのがちょっと残念。

全文検索がないのが残念。ああ、残念。


Java
---------
- The Always On feature allows applications to pay and keep 3 instances of
their application always running
, which can significantly reduce application
latency.
- Developers can now enable Warmup Requests. By specifying a handler in an
app's appengine-web.xml, App Engine will attempt to to send a Warmup
Request
to initialize new instances before a user interacts with it. This can
reduce the latency an end-user sees for initializing your application.
- The Channel API is now available for all users.
- Task Queue has been officially released, and is no longer an experimental
feature. The API import paths that use 'labs' have been deprecated. Task
queue storage will count towards an application's overall storage quota, and
will thus be charged for.
- The deadline for Task Queue and Cron requests has been raised to 10 minutes.
Datastore and API deadlines within those requests remain unchanged.
- For the Task Queue, developers can specify task retry-parameters in their
queue.xml.
- Metadata Queries on the datastore for datastore kinds, namespaces, and
entity
properties are available.
- URL Fetch allowed response size has been increased, up to 32 MB. Request
size is still limited to 1 MB.
- The Admin Console Blacklist page lists the top blacklist rejected
visitors.
- The automatic image thumbnailing service supports arbitrary crop sizes up
to
1600px.
- Overall average instance latency in the Admin Console is now a weighted
average over QPS per instance.
- Added a low-level AysncDatastoreService for making calls to the datastore
asynchronously.
- Added a getBodyAsBytes() method to QueueStateInfo.TaskStateInfo, this
returns
the body of the task state as a pure byte-string.
- The whitelist has been updated to include all classes from javax.xml.soap.
- Fixed an issue sending email to multiple recipients.
http://code.google.com/p/googleappengine/issues/detail?id=1623


水曜日, 11月 17, 2010

【JavaScript】 DOMをXMLに変換するjQueryプラグイン このエントリーを含むはてなブックマーク


 Reflex Tagging Serviceでは、GETはJSONPで、POSTやPUTはXMLで実行することを基本としている。そうしているのは、HTMLやJavaScriptといったコンテンツを扱う場合に、POSTやPUTまでJSONを使うのは結構面倒だということに気づいたから。(JSONの中にエスケープされたJSONを入れるのは大変だし読み解くのもつらい。)

 しかし、一度GETしたものを編集した後にPUTするような処理では、JSON->XMLへの変換が必要になる。そこで、jquery.entry2dom.jsという、jQueryプラグインを使って、JSONのオブジェクトをDOMに変換してからxmlに変換するようにしている。

 DOMからxmlに変換するには、jquery.dom2xml.jsを使えばよい。これは、DOMをXMLに変換をjQueryPluginにしたものである。

 ちょっと面倒に思えるかもしれないが、e4xがすべてのブラウザに対応していない現状ではしかたないかなと思っている。ちなみにサーバサイドにおける変換は、Rhinoが標準でサポートしているのでe4xを使っている。

月曜日, 11月 15, 2010

【Google App Engine】 言語選択について このエントリーを含むはてなブックマーク


にわかに盛り上がっているプログラミング言語選択の議論。私も一言いわせてくれ。

言語選択は目的と生産性で判断すべき


 以前、あるPython使いがGAEでJavaをやるなんてありえない!なんて主張しているのを聞いたことがある。
 たしかに、スクリプト言語特有の開発生産性の高さ、心地よさを覚えてしまったら後にはもう戻れない気がしてくる。それはよくわかる。

 私自身、プログラミング言語はアセンブラだけありゃ十分と真剣に思っていた頃もあったが、もう戻れない。(今そんな人いないよね。)
 
 でも、PythonかJava、どちらの言語を選択するかは、目的によって異なるんじゃないかと思う。

 私は今なら、人にすすめるならJavaScript、自分で書くならJavaが最高と思っている。(あれ?Pythonがない)
 
 Tagging Serviceでは、javaを選択しているが、その理由は、クラウドサービスのミドルウェアを作る必要があったからである。
 まず、サーバサイドスクリプト機能のようなJavaScript実行環境を作ることはPythonだと難しいと思った。(もしかしたらできるのかもしれないけど)
 これがJavaであれば、RhinoというJarを一つ追加するだけで作れてしまうのである。
 
 また、Reflex Tagging Serviceは、GAEだけではなく、RDBやCassandraのようなKVSでも動かすことを想定しており、その場合、エンタープライズ向けになることもあり、Javaの方が都合が良かった。
 
 もちろん、すべてJavaでいいといっているわけでなく、生産性向上のためには、JavaScriptを活用する方が有効だとも考えている。
 Tagging Serviceにおいて、ビジネスロジックはすべてATOMとjavaScriptで書けるようにしているのは、「人にすすめるならJavaScript」と、そう思うからだ。
 
 また、サーバとクライアントの言語を統一することは意外と重要だったりする。異なる言語で書いてしまうと、以下のように酷い目にあってしまうからだ。
 
 
pythonのコードに間違ってセミコロンを付けてしまったり、PythonとJavaScriptのどっちがTrueでどっちがtrueだか混乱したりする。(言語対決:JavaScript 対 Objective-C)

 
 どうせクライアントではjavaScriptが必須なわけだから、生産性という観点からいえば、サーバにおいても同じJavaScriptで書けるのが望ましいといえるだろう。
 
 まあ、趣味でやる場合は、プログラミングのためのプログラミングをすることもあるわけで、それはそれでいいんじゃないかとも思う。(でも、その話とエンジニアの素質は別の話だと思っているが・・)

宣言型プログラミングのすすめ


 あと一つ強調したいのは、jQueryが宣言型プログラミングモデルに近いということ。

 HTMLやCSSをマスターできた人がプログラミングに挑戦しようと思ってもなかなかできないのは、手続型の論理思考が難しいからということではないかと私は考えている。
 jQueryであれば、すんなりマスターできたという人が多いのは、HTMLやCSSと同じようなイメージで書ける、宣言型プログラミングモデルであるから。
 宣言型プログラミングモデルは、Javaなどの手続型(異論もあるとは思うが少なくとも宣言型ではない)に比べ、はるかに学習コストが低いと思われる。
 
 Tagging Serviceでは、ATOMとJavaScriptでRESTfulに開発できる環境を用意して、jQueryのような宣言型プログラミングモデルの仲間入りを果たすことで、プログラミング初心者でも、GAEのことを何も知らなくても、誰でも簡単にWebアプリケーションを作れる環境を提供している。
 
 以上、生産性の観点からいえば、多くの異なる言語を覚えて書くよりは、どれか強力な言語を覚えて書けるようにした方がいいという話でした。

 ちなみに、iPhone/iPadのNativeアプリの開発も、Titanium Mobile を使えば、JavaScriptだけで開発できるそうな。

土曜日, 11月 13, 2010

【Google App Engine】 ajn#12が終わりました このエントリーを含むはてなブックマーク


 皆様、盛り上げてくれて、本当にありがとうございました。めちゃ楽しかったです。
 私の発表資料を置いておきます。詳細はこちら

 atsさんのAHAの話は、Tagging Serviceと同じCMSということもあって大変参考になりました。
 佐藤さんの話は大変刺激しげき的でした。Matcherとか、概念が新しすぎて質問がまともにできなかった。

 teradaも、話をフルたびに(><;になってましたが、今回はかなり勉強になったと思います。やってよかった。

 shin1ogawaへ。飾りじゃないのよ、私は、Haha~


Thx! urekat san

発表の様子

Thx! kazunori san

金曜日, 11月 12, 2010

【Google App Engine】 Reflex Tagging Serviceについて話します このエントリーを含むはてなブックマーク


 弊社はかねてより、Reflexというリソース志向のフレームワークを提供しているが、このたび、さらにサービスに発展させたReflex Tagging Serviceというものを作ったので発表したいと思う。(明日のajn12のBTで話す予定なので、興味のある方はぜひ聴きにきてください。)

Reflex Tagging Serviceとは


 Tagging Serviceは、リソースから様々なReflex(反射像)を取り出すというReflexの基本設計に則って作成されたサービスであり、URLで示された階層のリソースに対して、ATOM Feedを使ってCRUD(GET/POST/PUT/DELETE)操作を可能にする。

 ATOMのAPIといえばGDataが有名だが、Tagging Serviceは、GDataプロトコルとほぼ同等の機能(REST API、JSON表現、Versioningなど)を持つほか、URLによるリソースの階層表現、ACL、WebHook、JavaScript実行機能などを備えている。

 詳細については、こちらを参照していただきたい。⇒リンク


サービス志向、もとい、リソース志向


 Reflex Tagging Serviceは、リソース志向の階層型CMS&ワークフローエンジンである。リソース志向とは、簡単にいえば、URIで表されるリソースに対してRESTfulにアクセスする世界のこと。REST APIを提供することで、Key/ValueであるDatastoreの扱いにくさを解消させる目的がある。でもそれ以上に、ドメイン層をサービス化して疎結合とすることで、スケーラビリティが向上し、可搬性が高まることの意味の方が大きい。 

 また、ドメイン層のサービス化については、以前、この記事の「ドメインサービスとしてのReflex BDB」で以下のように説明した。


Key/ValueStorageではなく、ドメインサービスを提供する
 ・ 単なるPKによるGET/PUTだけでなく、様々なKeyによるRESTfulなCRUD APIを提供
 ・ <>比較、Range、前方一致検索、全文検索、Pagingなど


 Reflex Tagging Serviceは、要は、このとき作ろうとしたドメインサービスなのである。当のReflex BDBの開発は中断しているが、いずれ、Tagging Serviceと同じAPIを導入しようと考えている。DBMSはRDBかもしれないし、KVSのCassandraになるかもしれないが、Tagging Serviceをラッパーにすることで、Private CloudでもPublic Cloudでも同じように動かすことができる。

 例えば、以下のような商品検索サービス(リンク)は、Tagging Serviceを基に作成されているが、REST APIだけで動作しているので、Private Cloudの上でも問題なく動作するはずである。


そして、JavaScriptだけが残った


 Reflex Tagging Serviceの目玉機能にServer Side Scriptがある。これを使えば、サーバでJavaScriptを実行できるようになる。ドメインサービスとしての機能以上に、ワークフローエンジンとして使用できるように作られているのがポイントである。

 サーバでスクリプトを実行できれば、JSPはいらなくなるし、Javaをデプロイする必要もなくなる。

 Reflex Tagging Serviceの目的は、GAEやDatastoreの難しさ、煩わしさをなくすことであった。特殊なスキルがなくても、REST APIだけ知っていれば、アプリを作ることができるようになる。

 実際に、先ほどの商品検索アプリは、GAEなんて全く知らない、JavaScript暦3ヶ月のKeigo君が作成したものだ。ちなみに、Tagging Serviceは、Teradaさんが作成したもので、私は1行もコードを書いていない。

 
© 2006-2015 Virtual Technology
当サイトではGoogle Analyticsを使ってウェブサイトのトラフィック情報を収集しています。詳しくは、プライバシーポリシーを参照してください。